
Sectigo 網誌
Let's Encrypt 營運 CT 日誌的實踐方式
[本文為客座文章,最初於2019年11月20日發布於 Let’s Encrypt 官方網誌。] Let’s Encrypt 推出了一款證書透明度(CT)日誌於今年春季推出了該日誌。我們希望分享搭建該日誌的經驗,供其他相關方參考借鑒。。。Sectigo和Amazon Web Services為我們提供了大力支持,承擔了 CT 日誌營運的大部分成本。

[註:本文最初於2019年11月20日發布在Let's Encrypt 網誌上。經 Let's Encrypt 許可,Sectigo 現將這篇實用內容分享給讀者。]
Let’s Encrypt 推出了一款證書透明度(CT)日誌於今年春季推出了該日誌。我們希望分享搭建該日誌的經驗,供其他相關方參考借鑒。證書透明度(CT)已快速成為互聯網安全基礎設施的重要組成部分,但營運一套高質量的日誌服務並非易事。CT 社區越充分分享已有的實踐經驗,整個生態系統就會越完善。
Sectigo以及Amazon Web Services為我們提供了大力支持,承擔了 CT 日誌營運的大部分成本。Sectigo 首席信息官 Ed Giaquinto 表示:“Sectigo 很榮幸能夠贊助 Let’s Encrypt CT 日誌。我們相信這項舉措將為 CT 生態系統提供亟需的支撐。”
如需了解 CT 及其工作原理的更多背景資訊,建議閱讀《證書透明度工作原理.”
如果您對本文所述內容有任何疑問,歡迎在我們的社區論壇.
目標
- 擴展能力:Let’s Encrypt 的證書簽發量超過 每日100萬張證書,而且這個數字每月持續增長。我們期望日誌不僅收錄我方的證書,也能收錄其他證書頒發機構(CA)的證書,因此需具備每日處理200萬張甚至更多證書的能力。為了支撐持續增長的證書規模,證書透明度(CT)軟件與基礎設施需要按可擴展要求進行架構設計。
- 穩定性與合規性: 我們的目標是達到99%的正常運行時間,單次中斷時長不超過24小時,符合Chromium與AppleCT政策要求。
- 分片: CT日誌的最佳實踐是將其拆分為多個時間分片。有關時間分片的更多資訊,請查閱這些博客 文章.
- 低維護成本: 人力成本較高,我們希望盡可能減少基礎設施維護耗費的時間。
系統架構
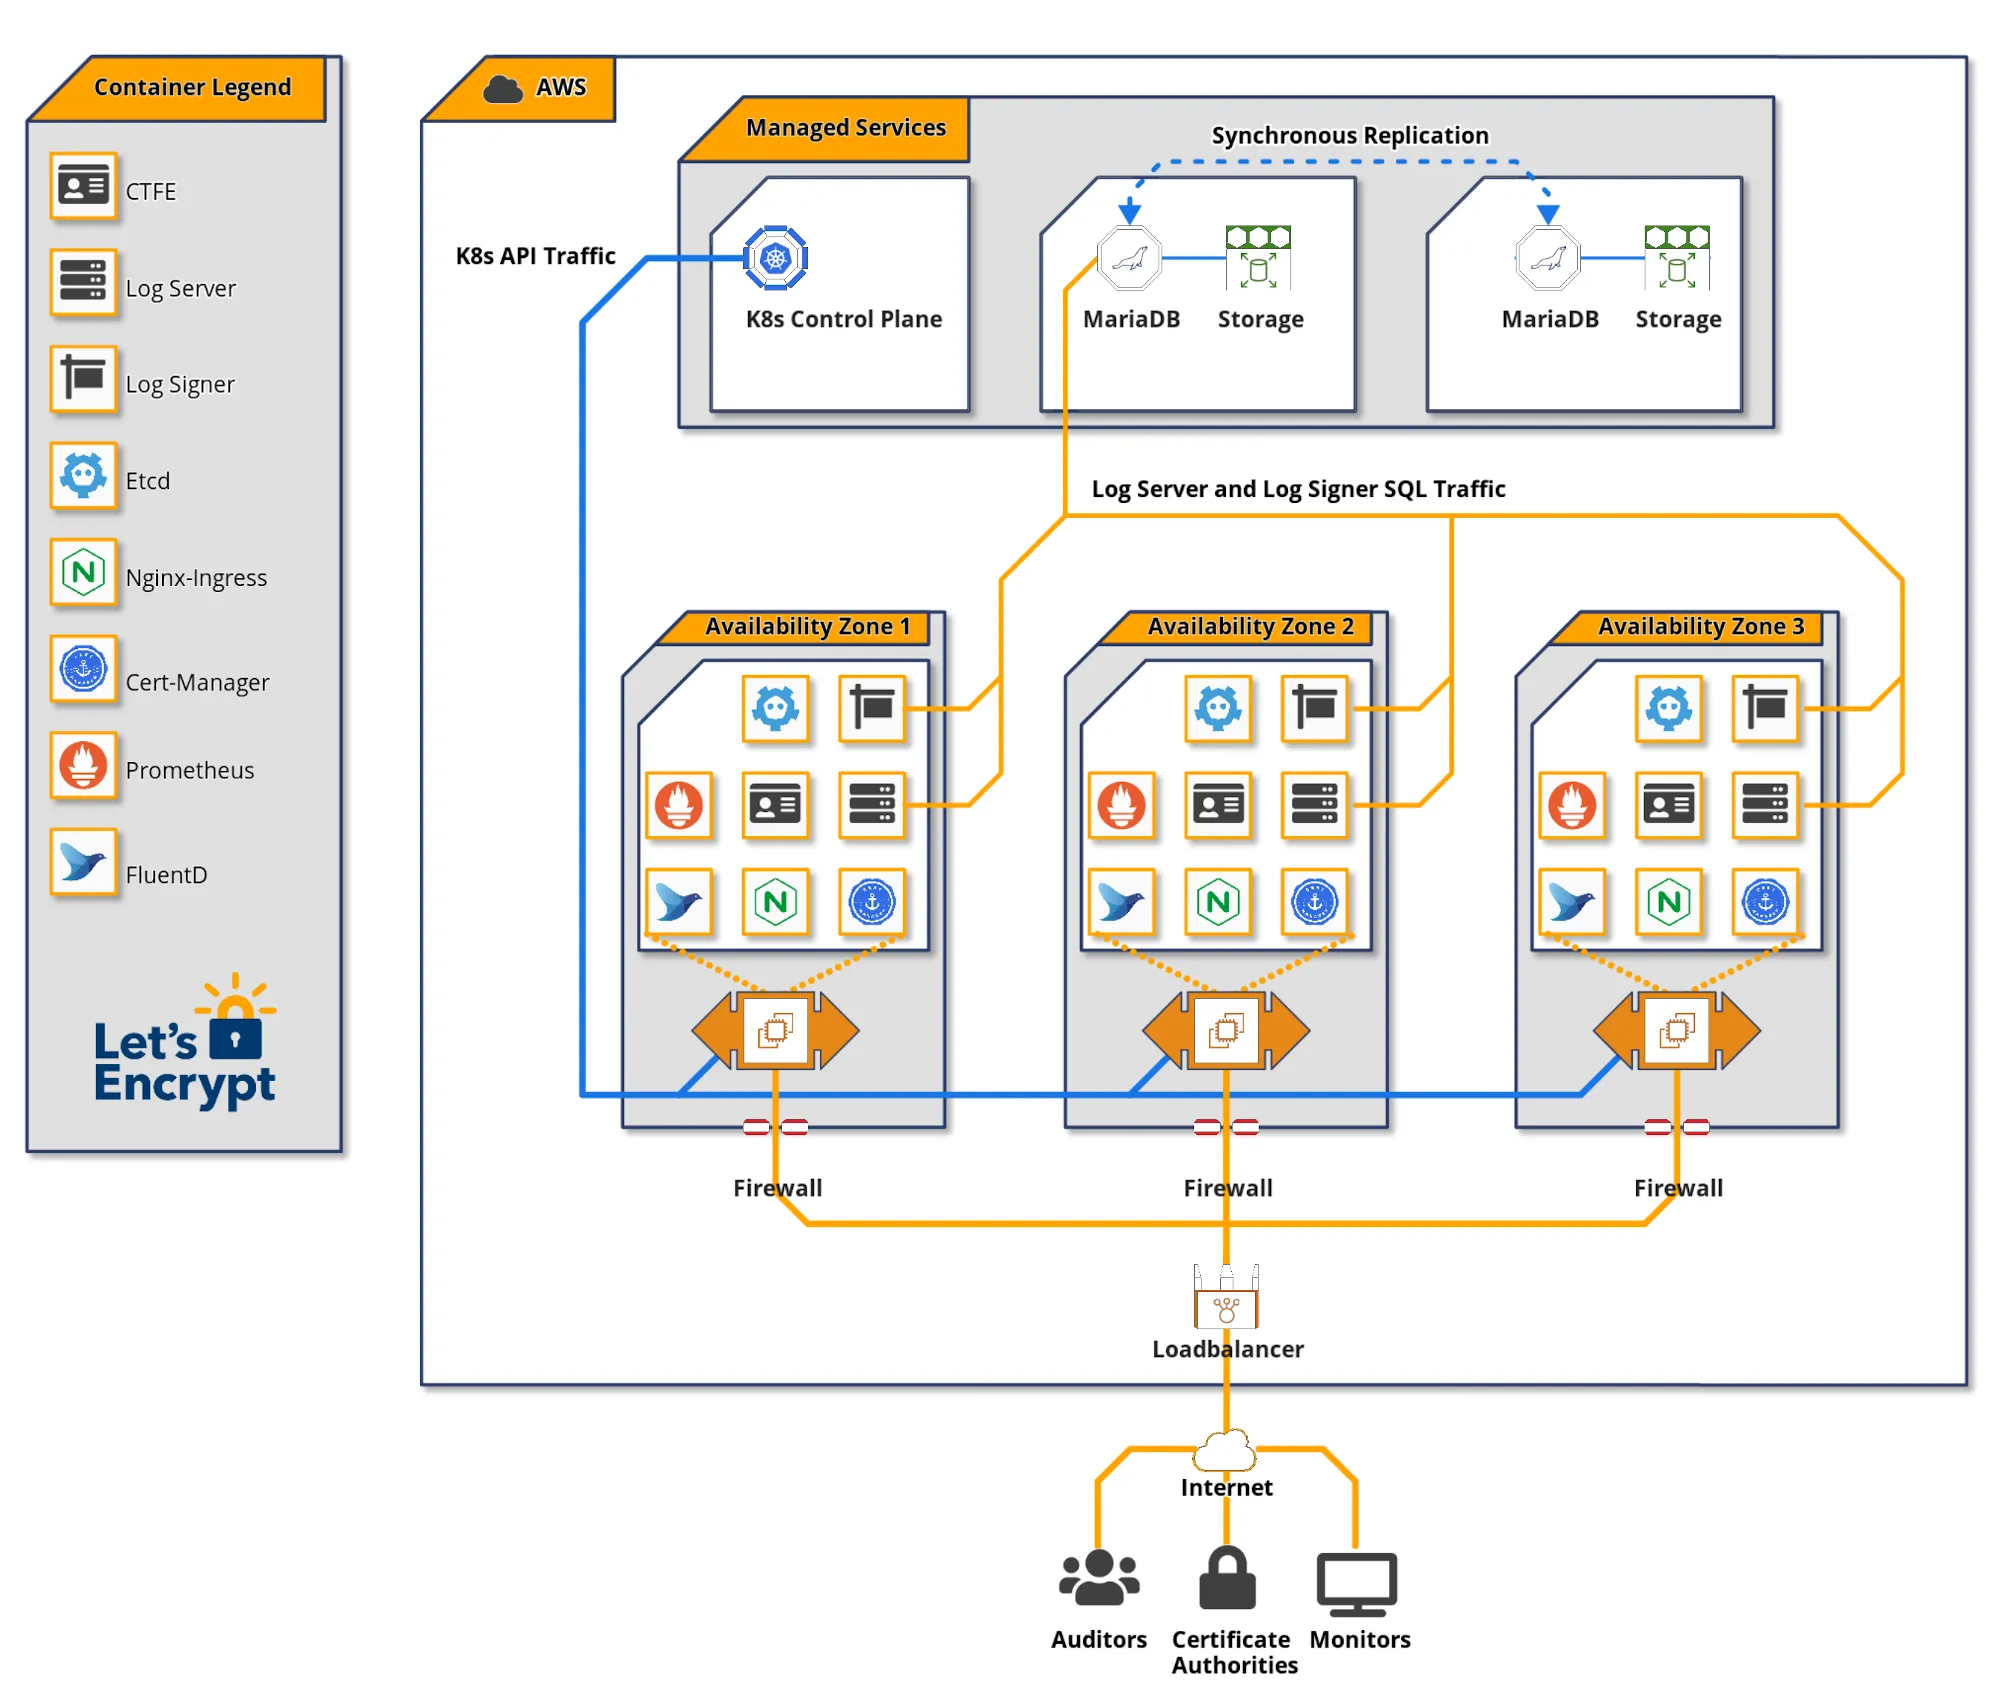
預發布環境日誌與生產環境日誌
我們營運兩套對等的日誌,分別用於預發布環境和生產環境。所有計劃應用到生產日誌的變更,都會先部署到預發布日誌。這是確保更新與升級在部署到生產環境前不會引發問題的關鍵環節。你可以在我們的文檔.
中找到這些日誌的存取詳情。我們會讓預發布日誌持續承受生產級別的負載,確保所有與規模相關的問題首先在預發布環境中顯現。我們還使用預發布CT日誌提交來自我方預發布CA環境的證書,並向其他CA的預發布環境開放該日誌供其使用。
需要說明的是,我們認為一套日誌由多個時間分片組成。儘管每個分片在技術層面是獨立的日誌,但從概念上將這些分片歸屬到同一條日誌下更便於理解。
Amazon Web Services (AWS)
我們選擇在AWS上運行CT日誌主要出於兩點原因。
第一個考量是雲服務供應商多樣性。由於證書生態系統中受信任的日誌數量相對較少,我們不希望因單一雲服務供應商故障導致多條日誌同時離線。在我們做出該決策時,已有運行在Google、Digital Ocean基礎設施上的日誌,以及自託管日誌,當時我們沒有發現運行在AWS上的日誌(事後看來我們可能遺漏了Digicert已開始使用AWS部署日誌的情況)。如果你計劃搭建供CA使用的受信任日誌,請將雲服務供應商多樣性納入考量。
此外,AWS提供成熟完善的功能集,我們的團隊也有在其他場景下使用AWS的經驗。我們完全相信AWS能夠勝任這項任務。
Terraform
Let’s Encrypt在多個雲項目中使用HashicorpTerraform。我們透過複用已有的Terraform程式碼快速完成CT日誌基礎設施的搭建。我方的CT部署包含約50個組件,涵蓋EC2、RDS、EKS、IAM、安全組以及路由組件。集中管理這些程式碼讓我們的小型團隊能夠在全球任意亞馬遜區域複現CT基礎設施,避免配置漂移,並且可以便捷地測試基礎設施變更。
數據庫
我們選用MariaDB作為CT日誌數據庫,因為我們在營運證書頒發機構(CA)方面具備豐富的MariaDB使用經驗。在我們成長為最大的公開受信任證書頒發機構(CA)的過程中,MariaDB展現出優秀的擴展能力。
我們選擇由Amazon RDS託管MariaDB實例,原因是RDS支援向備用叢集成員進行同步寫入。這項特性可實現數據庫自動故障切換,保障數據庫一致性。對CT日誌而言,向數據庫副本執行同步寫入至關重要。若故障切換期間漏寫一筆記錄,便可能導致某張數碼證書未按承諾寫入日誌,繼而有機會令日誌被取消資格。由RDS負責管理該機制可降低運維複雜度、節省人員時間。數據庫的性能管理、調優與監控仍由我們自行負責。
必須仔細評估CT日誌數據庫所需的存儲容量,這一點十分重要。存儲容量不足會導致需要開展耗時且存在潛在風險的存儲遷移;存儲容量過高則會產生不必要的高昂成本。
粗略估算的存儲基準為每1億條記錄佔用1TB空間。我們預計每個年度時間分片需存儲10億張數碼證書和預證書,對應需要10TB存儲空間。我們曾考慮為每個年度時間分片配置獨立的數據庫存儲,為每個分片分配約10TB空間,但該方案成本過高。最終我們決定為每個日誌建立12TB的存儲塊(10TB基礎容量加上一定預留空間),該存儲塊由RDS實現冗餘副本。我們計劃每年凍結上一年度的分片,將其遷移到成本更低的服務基礎設施上,從而回收其佔用的存儲資源供在線分片使用。
每個CT日誌的RDS我們使用2台db.r5.4xlarge實例,每台實例配置8個CPU核心、128GB內存。
Kubernetes
在嘗試過多種應用實例管理方案後,我們選用Kubernetes。Kubernetes的學習曲線較為陡峭,我們是經過審慎考量才作出這個決定。這是我們首個使用Kubernetes的項目,選擇該方案的部分原因是累積相關經驗,未來或會將相關技術應用到我們基礎設施的其他部分。
Kubernetes為運維人員提供了部署, 擴縮容、服務發現等抽象能力,無需我們自行構建相關功能。我們參考了Trillian程式碼儲存庫中的Kubernetes部署示例清單來輔助部署工作。
Kubernetes叢集由兩大核心組件構成:負責處理Kubernetes API的控制平面,以及運行容器化應用的工作節點。我們選擇由Amazon EKS託管我們的Kubernetes控制平面。
每個CT日誌的工作節點池我們使用4台c5.2xlarge EC2實例,每台實例配置8個CPU核心、16GB內存。
應用軟件
我們在Kubernetes叢集中運行三類核心CT組件。
證書透明度前端(即CTFE)提供RFC 6962端點,並將請求轉換為發送至Trillian後端的gRPC API請求。
Trillian將自身描述為「透明、高可擴展且可加密驗證的數據存儲」。本質上,Trillian透過默克爾樹實現了通用的可驗證數據存儲,可透過CTFE作為CT日誌的後端。Trillian包含兩個組件:日誌簽名器(log signer)和日誌伺服器(log server)。日誌簽名器的作用負責定期處理傳入的葉子數據(在CT場景下即數碼證書),並將這些數據整合到默克爾樹中。日誌伺服器則從默克爾樹中檢索對象,以回應CT API的監控請求。

負載均衡
流量透過映射到Kubernetes Nginx Ingress服務的Amazon ELB進入CT日誌。Ingress服務在多個Nginx Pod之間進行流量負載均衡,Nginx Pod再將流量代理到CTFE服務,由CTFE服務將流量均衡分發至各CTFE Pod。
我們在此Nginx層部署了基於IP和用戶代理的速率限制機制。
日誌記錄與監控
Trillian 及 CTFE 會暴露Prometheus 指標,我們會將這些指標轉換為監控儀表板及告警。必須為 CT 日誌端點設定高於 CT 政策規定的 99% 正常運行時間要求的服務等級目標,才能確保您的日誌受信任。以 DaemonSet 方式運行的 FluentD Pod 會將日誌傳輸至集中式儲存,供進一步分析。
我們開發了名為ct-woodpecker的免費開源工具,用於監控日誌穩定性及正確性的各個維度。該工具是我們保障服務等級目標達成的重要組成部分。每個 ct-woodpecker 實例均在承載 CT 日誌的 Amazon VPC 外部運行。
未來效率優化方向
以下是我們未來可能用於提升系統效率的部分方向:
- Trillian 會儲存每條證書鏈的副本,當中包含大量相同中繼證書的重複副本。若能在 Trillian 中實現此類重複數據的去重,將可大幅降低儲存成本。我們計劃研究該方案的可行性及合理性。
- 驗證是否可採用成本低於 IO1 區塊儲存與預置 IOPS 的儲存形式。
- 驗證是否可縮小 Kubernetes 工作節點使用的 EC2 實例規格,或減少 EC2 實例的使用數量。